string和&str
rust中操作字符串比较常用的是String和&str 比如:
1
2
3
4
5
6
| let string = String::from("hello, world");
//以下三种都为&str类型
let s = "hello, world"; //字面常量 string literal, 存储在常量区
let hello = &string[..5]; //从string中得到&str
let world = &s[6..]; //从&str中得到&str
|
内存布局
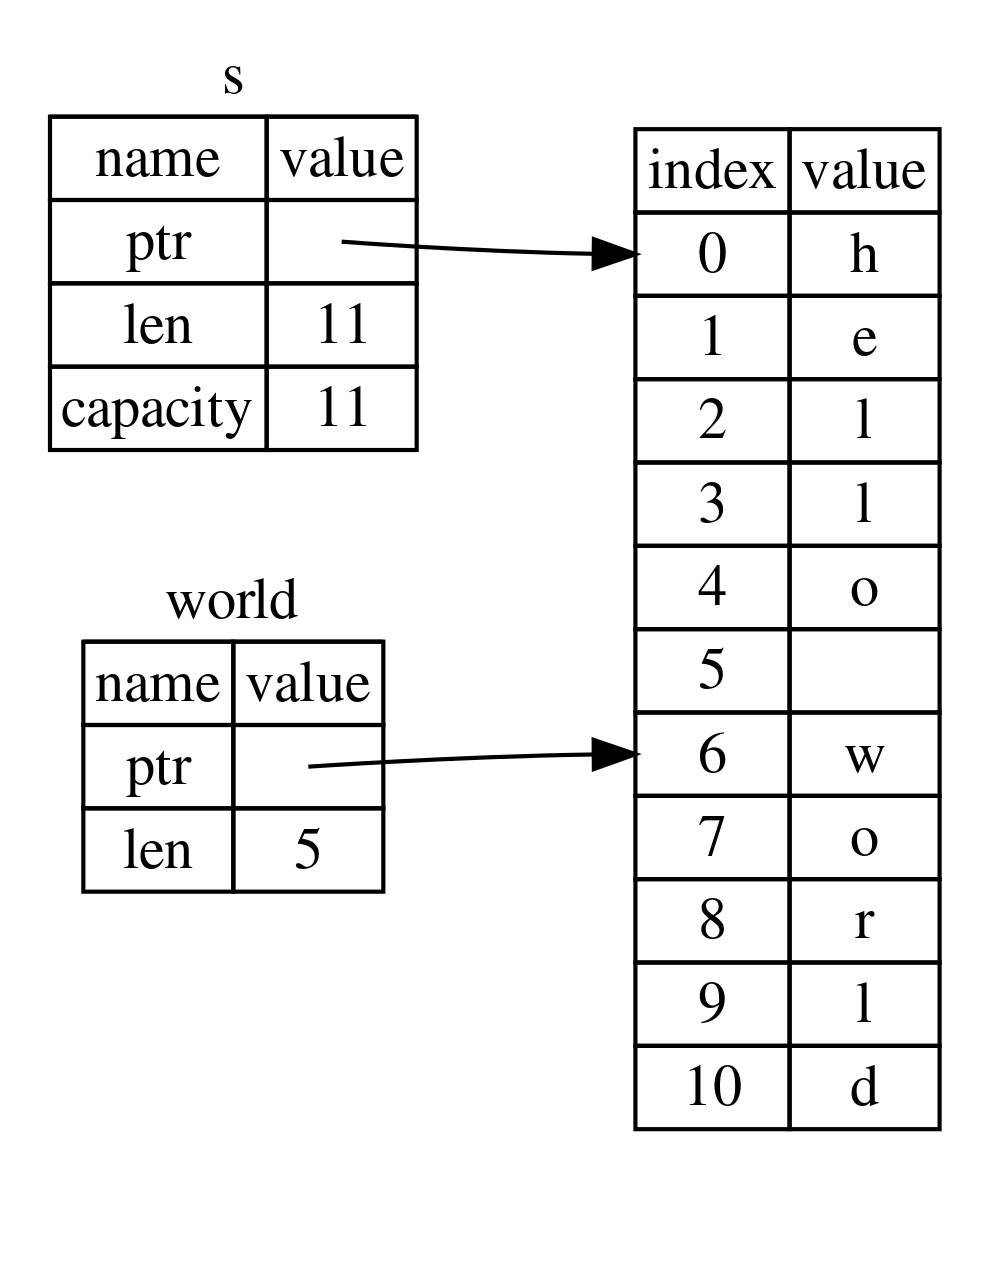
以下是String与&str在内存中的结构,String占用了3个字长,&str占用两个字长。他们都有一个指向底层数组的指针。
实现源码
string的内部实现就是一个Vec[u8]
1
2
3
4
5
| pub struct String {
vec: Vec<u8>,
}
|
vec本身的实现如下
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
| pub struct Vec<T, #[unstable(feature = "allocator_api", issue = "32838")] A: Allocator = Global> {
buf: RawVec<T, A>,
len: usize,
}
pub(crate) struct RawVec<T, A: Allocator = Global> {
ptr: Unique<T>,
cap: usize,
alloc: A,
}
|
以上可以看出string的内存占用从何而来
str是一个原生类型,字面常量的完整类型是&‘static str, 虽然没有str的类型定义,但是从它的方法中也可以找到它的内部结构
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
|
let story = "Once upon a time...";

let ptr = story.as_ptr();
let len = story.len();

// story has nineteen bytes
assert_eq!(19, len);

// We can re-build a str out of ptr and len. This is all unsafe because
// we are responsible for making sure the two components are valid:
let s = unsafe {
    // First, we build a &[u8]...
    let slice = slice::from_raw_parts(ptr, len);

    // ... and then convert that slice into a string slice
    str::from_utf8(slice)
};

assert_eq!(s, Ok(story));
|
str的其他使用方式
理论上可以通过各种方式得到str类型本身,然而编译器并不能通过, 主要是因为str类型为unsize type, 并不能够在栈中存在。比如
1
2
3
4
5
6
7
8
9
| let string = String::from("hello, world");
let s = "hello, world";
//以下三个变量都为str类型
let ss = *s;
let h = string[..5];
let w = s[6..];
|
Box<str>
既然str不能在栈上存在,那么能不能显式放到堆上呢?答案是可以的,那就是Box<str>,但是Box<str>只能通过以下一种方式初始化
1
2
3
4
| let string = String::from("hello, world");
//除了&str,你还可以使用Box<str>,下面是可以创建Box<str>的唯一方法
let box_s = string.into_boxed_str();
|
Box<str>同样是占用2个字长,事实上,当一个unsize type被放在引用或者指针后面的时候它就是一个2字长胖指针,比如&[u8], &dyn Trait都是如此, *const [T]也是一样
Cow<str>
很多时候,我们希望函数接口保持兼容性与灵活性,通常使用&str而不是String或者·&String作为接口,但是作为返回,如果这个函数并没有修改这个&str,那么我们希望可以直接返回它, 但是当这个函数改变了值,我们只能复制这个str并且返回String类型以获得owned值。这个时候Cow<str>就派上了用场。以下是定义
1
2
3
4
5
6
7
| pub enum Cow<'a, B>
where
B: 'a + ToOwned + ?Sized,
{
Borrowed(&'a B),
Owned(<B as ToOwned>::Owned),
}
|
- 标准库中,对于
Cow<str>的使用有from_utf8_lossy返回&str
1
2
3
4
5
6
| // some bytes, in a vector
let sparkle_heart = vec![240, 159, 146, 150];
let sparkle_heart = String::from_utf8_lossy(&sparkle_heart);
assert_eq!("💖", sparkle_heart);
|
- 返回
String, 由于修改了字符串内容, 重新复制了内存
1
2
3
4
5
6
|
// some invalid bytes
let input = b"Hello \xF0\x90\x80World";
let output = String::from_utf8_lossy(input);

assert_eq!("Hello �World", output);
|
- 在crate
regex中有一个replace方法,同样使用Cow<str>作为返回值
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
| pub fn replace_all<'t, R: Replacer>(
&self,
text: &'t str,
rep: R,
) -> Cow<'t, str> {
self.replacen(text, 0, rep)
}
|
- 我们可以直接使用
Cow<str>, 打印或者写入文件
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
| //new 一个正则表达式
let regex = Regex::new(target).unwrap();
//返回一个Cow<str>
let cow = regex.replace_all(text, replacement);
//打印字符串
println("str is {}", cow);
//输出到文件, 这个需要注意&*cow得到&str类型
// &(*cow.deref())
fs::write("output.txt", &*cow)
|